Югорские ученые научили нейросеть читать мансийский язык: точность распознавания выросла в 20 раз
Специалисты Югорского НИИ информационных технологий создали высокоточную модель оптического распознавания символов (OCR) для мансийского языка. Проект, детали которого опубликованы на платформе "Хабр", решает проблему оцифровки малоресурсных языков.
Главное достижение
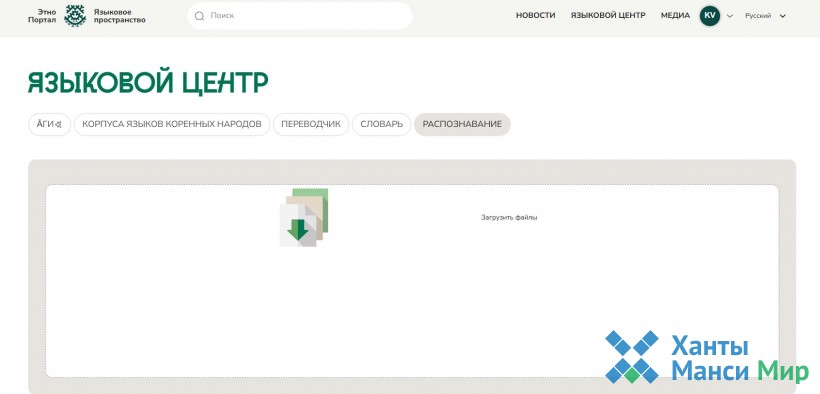
Команда дообучила открытый движок Tesseract 5, в результате чего доля ошибочных символов при чтении мансийского текста упала с 18,5% до 0,85%. Это означает примерно 20-кратное снижение ошибок. Обученная модель (файл mns.traineddata) уже доступна в открытом доступе на платформе Hugging Face, а протестировать распознавание можно на «Этнопортале» Югры.
Зачем мансийскому языку OCR
Большая часть мансийских текстов — книги, учебники, сборники фольклора и подшивки газет — до сих пор существует только на бумаге. Ручной набор таких объемов нецелесообразен, а носителей языка мало, и их время лучше тратить на перевод и экспертизу. Оцифровка позволяет превратить бумажные архивы в машиночитаемый текст для пополнения корпуса языка, на котором обучаются нейросетевые переводчики.
Технические вызовы и их решение
Стандартные OCR-движки не справлялись с мансийским текстом по двум причинам:
- Специфические буквы: В алфавите есть долгие гласные с макроном (а̄, о̄, ӯ) и буква ӈ. Базовая русская модель Tesseract теряла диакритические знаки или превращала их в "мусор".
- Проблемы Unicode: Одну и ту же букву с макроном можно записать в кодировке разными способами (как единый символ или как букву плюс комбинируемый знак). Для машины это разные символы.
Чтобы обучить модель, которой требуется сотни тысяч примеров, ученые не стали вручную размывать сканы. Вместо этого они сгенерировали 1,3 миллиона синтетических пар "картинка — текст". Для этого настоящие мансийские тексты нормализовали по форме Unicode NFC, а затем отрендерили несколькими десятками шрифтов (от FreeSerif до Times New Roman) в разных размерах и начертаниях. Для точной разметки букв с диакритикой специалисты вручную скорректировали три словаря смещений (CHAR_OFFSETS, CHAR_SIZE, RATE), чтобы рамки символов не обрезали макроны.
В качестве основы взяли русскую модель Tesseract (rus.traineddata), которая уже хорошо знает кириллицу. С помощью официального набора скриптов tesstrain ученые расширили ее алфавит, добавив специфические мансийские буквы. Чтобы избежать переобучения на синтетических данных, применили метод ранней остановки.
Результаты в цифрах
Сравнение на тестовой выборке показало колоссальный разрыв:
Модель
Ошибки символов (CER)
Ошибки слов (WER)
Базовая русская (rus.traineddata)
18,5%
42,1%
Новая мансийская (mns.traineddata)
0,85%
1%
Там, где базовая модель превращала слово "Хӯл" в "Хул", а "ва̄рнэ" в "варнэ", новая версия распознает строку "Хӯл тэ̄нутыг ва̄рнэ ма̄гыс" без единой ошибки.
Практическое применение и планы
Текущая точность уже достаточна для массовой оцифровки печатных изданий: человеку остается лишь вычитать результат, а не набирать текст заново. Модель уверенно работает с чистым типографским текстом кеглем от 12 до 26 pt.
В планах исследователей — добавить в обучение настоящие архивные сканы со стертой печатью и устаревшими шрифтами. По мнению авторов, этот же метод подойдет для других языков с диакритикой на кириллице, например, хантыйского или ненецкого.
В следующих материалах цикла команда планирует рассказать о создании языковой модели, а также систем распознавания и синтеза мансийской речи. Подробное научное описание методики опубликовано в журнале "Вестник ЮУрГУ" (DOI: 10.14529/mmp260206).
Галина Кондина